
結論: 「AI外部脳」とは、自分が集めた素材(記事・メモ・動画の書き起こしなど)をAIに読ませ、出典付きで文脈に沿った回答を返す“自分専用の知識データベース”です。Claude Codeを使えば、フォルダに素材を入れて「読んでWikiを作って」と頼むだけで、小さな題材から構築を始められます。
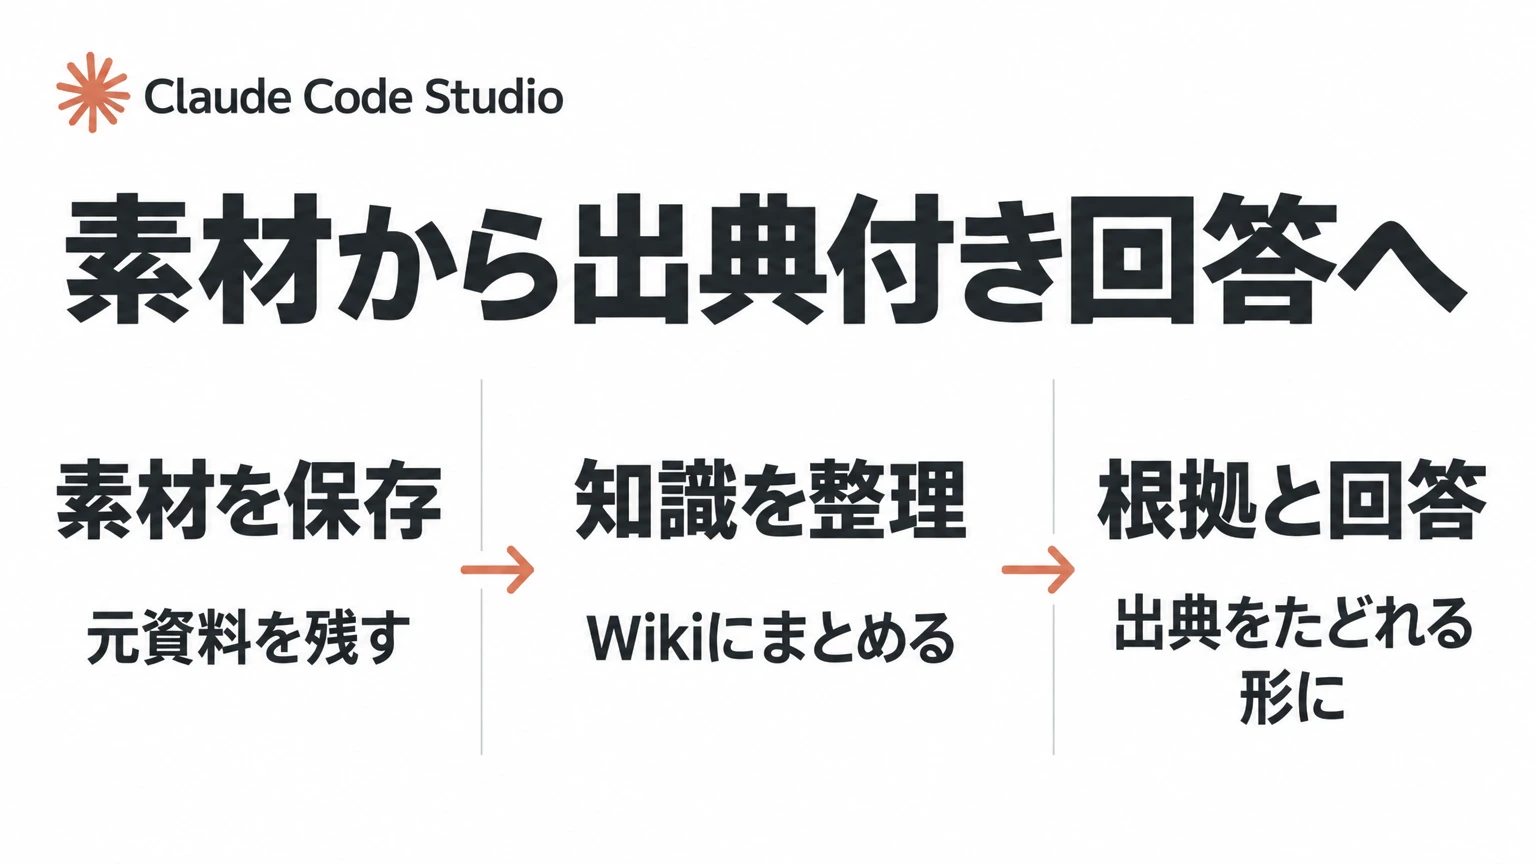
- 要点1: 外部脳では素材と出典をファイルに残し、後の回答に再利用できます。追加した資料と回答を確かめながら、知識を更新していきます。
- 要点2: 原典を置くrawと、整理した説明を置くwikiを分け、小さな資料群で作成・質問・確認を一巡します。
- 要点3: 会社のナレッジにも応用できます。共有する場合は、閲覧権限・更新担当・正本を決めて運用します。
対象読者: AIを毎日使うが「毎回イチから説明し直すのに疲れた」経営者・個人事業主・企業の実務責任者
読了後にできること: 小さな知識ベースを作り、集めた資料とAIの回答を出典で照合する流れを試せます。
元資料:Claude Code Studioの元の公開X記事。2026年10月7日確認。
元OpenAI、元Tesla AI部門トップのAndrej Karpathyが、自身のAI活用法として「LLM Knowledge Base(LLMナレッジベース)」を公開しました。ひとことで言えば「AIが読み書きできる、自分専用の知識データベース」——通称AI外部脳です。海外の開発者コミュニティで大きな話題になり、同じ仕組みをClaude Codeで誰でも再現する手順が数千いいねを集めました。
株式会社PLaiでは、AIが読める知識ベースを業務に利用しています。事業ナレッジ・判断基準・日々の記録をObsidianに貯め、Claude Codeから参照する運用です。この記事では、その出発点となるAI外部脳を、初心者から開発者まで3段階で作る方法を紹介します。会社の売上や制作実績を、この仕組み単独の効果として測定したものではありません。
公開X記事を読み直す:原案と実装ガイドを区別する
2026年4月11日にClaude Code Studioが紹介したのは、KarpathyのLLM Wikiの発想を、hooeem氏が段階的な構築手順に落とし込んだ記事です。以下の具体的なフォルダ構成や導入段階を、すべてKarpathy本人が使う唯一の方法だとは扱いません。
原案を確かめる場合は、KarpathyのLLM Wikiへ戻ります。Xで紹介したhooeem氏の実装ガイドとは、提案者と説明の範囲を分けて読みます。
素材・整理済みの知識・運用規則を分ける
raw/には取得日と出典を付けた素材、wiki/にはそこから整理した説明、CLAUDE.mdには更新や回答の規則を置く、という構成が出発点になります。ObsidianのVault(ノートを保存するフォルダ)はローカルのファイルを扱うため、Claude Codeで作るMarkdownも知識管理へ組み込みやすくなります。
重要なのは、要約で原文を置き換えないことです。Wikiの説明に疑問があれば、元の資料へ戻れる状態を保ちます。同じテーマで新しい資料が出たときも、以前の判断が何を根拠にしていたかを比較できます。
最初の題材は、小さく答え合わせできるものを選ぶ
例えば社内で公開可能な製品資料を3件集め、「どの資料がどの仕様を説明しているか」を答えさせます。これは構築例であり、PLaiで精度を測定した結果ではありません。回答に引用元が付くか、資料にないことを推測で補わないか、古い資料と新しい資料の違いを示せるかを確認します。
raw/ の資料だけを使い、製品Aの導入条件をまとめてください。
各条件に出典ファイルと該当箇所を付けてください。
資料間で矛盾する点は、どちらかを採用せず併記してください。
根拠のない条件は「資料からは確認できない」と書いてください。
更新を任せても、知識の正しさは別に確認する
リンク切れ、重複、古い仕様を点検する手順を作れば、維持の負担を減らす助けになります。ただし「使うほど必ず賢くなる」「メンテナンスが完全に不要になる」とは限りません。素材の品質、整理の方法、更新する担当がそろって初めて、仕事で参照しやすい知識になります。
会話とは別に、出典と判断を管理する理由
ChatGPTやClaudeに質問するだけでも、履歴やメモリを利用できる場合があります。ただし、使える機能や設定によって、次の会話へ引き継がれる情報は異なります。過去の判断や出典を自分で管理したいときは、会話とは別に資料を残す方法が役立ちます。
先週調べたこと、先月の判断、自分の仕事の前提をファイルにまとめておけば、必要な場面でAIへ渡し直せます。すべての文脈が自動で共有されるわけではないため、何を読ませるかを指定し、回答の前提を確かめます。文脈の渡し方は、コンテキストエンジニアリングの記事でも解説しています。
KarpathyのLLM Wikiは、原典と整理した知識をファイルとして扱う構想です。必要な情報を参照し、誤りや古い記述を見つけたら更新する運用へつなげます。
「AI外部脳」の仕組み──素材を集めるとAIがWikiを自動生成する
考え方はシンプルです。自分が普段集めている情報——記事、論文、YouTube動画の書き起こし、PDF、メモ、何でもいい——を1箇所に集めます。そこにAIを読ませ、構造化されたWiki(まとめ)を自動で作らせます。このWikiには、各素材の要約だけでなく、概念同士のつながり、重要な点の整理、全体を探せる索引も含めます。
Wikiを参照して質問に答えるよう依頼すると、集めた素材の内容やつながりを確認しやすくなります。回答を素材の範囲に限定したい場合は、その条件を明示し、根拠となるファイルや箇所も示してもらいます。AIが別の知識を混ぜたり、出典を取り違えたりする可能性はあるため、重要な回答は原典と照合します。素材を追加した後も、整理された内容と出典の対応を確かめます。
普通のAIチャットとの決定的な違い
| 普通のAIチャット | AI外部脳(Claude Code) | |
|---|---|---|
| 知識の元 | モデルの知識や会話で渡した資料 | 利用者が指定した素材・Wikiを参照させる |
| 記憶 | 製品や設定により履歴・メモリを利用する | 素材・整理結果・更新履歴を利用者がファイルで管理する |
| 回答の確認 | 回答の前提や根拠を確認する | 素材や出典と回答の対応を確認する |
| 更新 | 製品のメモリや履歴、渡す資料を必要に応じて見直す | 資料と回答を確認しながらWikiを更新する |
| 前提の説明 | 必要な条件を会話などで渡す | 共通の前提をファイルで渡し、今回の目的や例外を補う |
ポイントは「蓄積」と「出典」です。知識をファイルに残し、AIが参照できる形にします。使った結果を確かめて修正することが、継続的なAI活用につながります。
ObsidianとClaude Codeを組み合わせる理由
知識ベース自体は他のツールでも作れます。Notion AI、Obsidianのプラグイン、RAGシステムなど選択肢はあります。それでもClaude Codeで作る理由が3つあります。
理由1:セットアップが圧倒的に楽。 Claude Codeはターミナルから直接ファイル操作ができるので、フォルダを作って素材を入れるだけで始められます。専用データベースもAPIの設定も不要です(導入方法はClaude Codeのインストール手順を参照)。
理由2:AIにWikiの作成を頼める。 資料を検索して回答するRAGシステムを自分で構築する場合には、検索用データベースや資料の分割方法などを設定します。小さな資料群から始めるなら、Claude Codeへ「このフォルダの内容を読んでWikiを作って」と日本語で依頼する方法があります。
理由3:知識の参照と実装が一体化する。 たとえば技術ナレッジの外部脳を作れば、知識を引き出すだけでなく「その知識に基づいてコードを書く・資料を作る」まで同じ環境で完結します。Obsidianに素材を貯め、Claude Codeに読ませる組み合わせは特に手軽で強力です(詳しくはObsidian×Claude Code連携ガイド)。
3段階で作るAI外部脳【初心者→開発者】
ここからが本題です。同じ仕組みを、スキルレベルに応じて3段階で作れます。まずはバージョン1から。いきなり自動化を目指さず、手で10個入れるところから始めるのが挫折しないコツです。
原典を取り違えない小演習:架空の製品資料を2枚用意し、旧資料に「個人向け・上限10件」、新資料に「法人向け・上限30件」と書きます。「上限は何件か」という問いには、対象が違うため一方を最新版として上書きせず、個人10件・法人30件と出典を分けるのが期待する整理です。資料にない「料金はいくらか」には未確認と答えるかも確認します。日付だけで判断せず、対象プランや適用条件を併記する練習になります。
バージョン1:完全初心者向け(フォルダ1個とテキスト10個)
AIやプログラミングの経験がなくても作れます。手順はこうです。
- Claude Codeで作業フォルダを1つ用意し、その中に
knowledge-baseというフォルダを作る - knowledge-baseの中に、原典を保存するrawと、整理した説明を保存するwikiの二つのフォルダを作る
- 出典と取得日を付けた素材をrawに保存する。最初は内容を確かめられる少量から始め、AIが整理した文章と原典を混ぜない
- 素材が溜まったら、Claude Codeに次のように頼む
knowledge-base/rawの素材を読み、knowledge-base/wikiにテーマ別のWikiを作ってください。rawのファイルは変更・削除しないでください。各ページには要点と対応する出典ファイルを記載し、索引を作ってください。素材から確認できないことは不明と書き、推測で補わないでください。処理できなかった素材も最後に報告してください。
Claude Codeに素材の要約、概念整理、関連づけ、索引の作成を依頼します。生成されたWikiを読んで、原典と内容が合っているか、参照先が示されているかを確かめてください。その後はWikiを指定して質問し、素材を増やすたびに更新を依頼します。小さな資料群で流れを試してから、対象を広げると管理しやすくなります。
バージョン2:中級者向け(素材収集の自動化)
AIツールに慣れてきたら、バージョン1に「素材収集の自動化」を足します。手動で1つずつコピペするのは正直続かないからです。
- YouTube動画のURLを渡すだけで、書き起こしが自動で素材フォルダに保存される
- PDFをフォルダに入れるだけで、テキスト抽出されてWikiに反映される
- RSSフィードやブックマークから、関連記事が自動で流し込まれる
- カテゴリ別の分類を自動化し、誤分類がないかを人が確認する
定期更新まで任せる場合は、取得・整理・確認の起動条件を別に設計します。実行記録には、取得できなかった素材、更新したファイル、確認が必要な差分を残します。更新ジョブが起動しただけでは、内容の確認まで終わったとは判断しません。
バージョン3:開発者向け(連携と共有の拡張)
プログラミングができる人向けの最終形です。API連携、スケジュール実行、複数ナレッジベースの統合管理、チーム共有まで含みます。
- 朝起きたら、昨晩の最新ニュースがWikiに反映済み
- 特定トピックの新着論文が、サマリー付きで自動追加されている
- 「AI業界」「競合分析」「自社プロダクト」のようにテーマ別の複数ナレッジベースを横断検索できる
- チームで共有し、組織のナレッジハブとして運用する
これは自動化を広げる構成例です。Karpathy本人がこの一式を日常的に使っていることまで、本記事では確認していません。まず素材の保存と回答の確認ができる範囲から始めます。
なお、Wikiを使う基本の流れは、構造化・質問・更新です。先ほどの習熟度別の3バージョンとは別に、日々の操作として次の指示例を使えます。
# 第1段階: 構造化
このフォルダの資料を読んで、テーマ別の構造化Wiki(Markdown)を作って。
各項目に出典ファイル名を残して。

# 第2段階: 質問
◯◯について、Wikiを根拠に答えて。
根拠が無い部分は「資料に無い」と明示して。

# 第3段階: 更新
今日追加した資料をWikiに反映して。
結論が変わった項目は変更履歴を残して。ポイントは「出典を残させる」「無いものは無いと言わせる」の2つを最初から指示に含めることです。この2つを指示したうえで、回答と出典が対応しているかを確認し、経営判断の材料に使えるかを見極めます。
経営と実務で「AI外部脳」を使うとどうなるか
業務へ応用する例を挙げます。以下は、保存した資料を使ってどんな問いを確認できるかという提案です。実際に役立つかは、参照資料と回答を照合して判断します。
経営判断の場合。 業界レポート・競合の動き・自社の数字・過去の意思決定メモを外部脳に入れておき、「この投資判断、過去の似た判断と照らして懸念点は?」と聞く。一般論ではなく、自社の歴史と数字を踏まえた壁打ち相手になります。
商談メモ・提案書・失注理由を整理し、商談前に似た過去案件を調べる使い方が考えられます。出典をたどり、その案件へ適用できる条件かを確認します。
会議・議事録の場合。 過去の決定や担当者を記録しておくと、「先月決めた事項のうち、進捗が確認できないものは?」と調べる材料になります。議事録に書かれていない進捗は推測させず、担当者へ確認する項目として残します。議事録自動化の実践ガイドも参考にしてください。
マーケティングの場合。 過去の投稿・配信・数値を入れておけば、「反応が良かった投稿の共通点は?」「その型で来週分の下書きを作って」と、勝ちパターンが再利用できる資産に変わります。
引き継ぎ・属人化対策の場合。 ベテランの手順書・対応履歴・判断基準を外部脳化しておけば、退職や異動のたびに「あの人しか知らない」が会社から消えていきます。組織全体への広げ方は会社ナレッジのAI活用で解説しています。
新規事業リサーチの場合。 調査記事・統計・ヒアリングメモを集めて「このデータで裏づけられる仮説と、まだ根拠が無い仮説を分けて」と聞く。読んだ資料を根拠に答えるので、それらしい嘘(ハルシネーション)に経営判断を振り回されにくくなります。
| 業務 | 外部脳なしのAI | 外部脳ありのAI |
|---|---|---|
| 経営判断 | 一般論のメリット・デメリット | 自社の数字・過去の判断を踏まえた懸念点の指摘 |
| 営業準備 | 汎用の提案テンプレート | 類似案件の勝ち筋を反映した提案初稿 |
| 会議 | 毎回ゼロから経緯を説明 | 過去の決定・宿題を即座に参照して回答 |
| マーケ | それっぽい一般原稿 | 自社の勝ちパターン準拠の原稿 |
| 引き継ぎ | 必要な説明を個別に整理 | 蓄積した資料を参照し、不足を確認 |
この仕組みの本質──「聞いたら答える」から「育つ知識」へ
AI外部脳では、会話で使った知識や判断をファイルへ残し、次の依頼に再利用します。役立つ回答や訂正をWikiへ反映すれば、参照できる材料を増やしていけます。AIが自分から定期的に確認や提案を行う仕組みを作る場合は、この知識管理とは別に起動方法と確認の手順を設計します。
まずは手元の資料を整理する範囲で、小さなWikiを試せます。収集を自動化したりチームで共有したりする場合は、取得元の利用条件、費用、アクセス権、更新の担当を追加で決めます。原典の構想を理解したことと、自社の仕組みが動いたことは分けて確認します。
個人の外部脳を「会社のAI社員」に育てる
ここまでは個人の知識ベースの話でした。同じように原資料と整理した知識を分ける構成は、会社のナレッジにも応用できます。ただし、素材を入れ替えるだけでは足りません。誰が読めるか、誰が更新するか、どの情報を正本とするかを決めます。
PLaiでは、Obsidianに貯めた会社の知識をClaude Codeから参照し、HP制作・SNS運用・メルマガ・請求書作成などに利用しています。業務を実行させるには、役割の記述だけでなく、使うツール、権限、起動条件、成果物の確認方法も必要です。会社版の作り方はナレッジ構築の5ステップ、前提を教える設定ファイルはCLAUDE.mdの書き方完全ガイドで解説しています。
小さく始めるなら、まず既存の資料を整理する範囲で試せます。必要な費用や手間は、利用するClaude Codeのプラン、資料量、収集や実行をどこまで自動化するかで変わります。素材を集める時間に加え、生成された内容の確認と更新の時間も見込んでください。
AI外部脳を最短で立ち上げる実務チェックリスト
最後に、初心者・中級者・開発者の各バージョンに共通する基本の流れを、素材集め・構造化・運用の3工程でまとめます。
| 段階 | やること | 確認すること | 成果物 |
|---|---|---|---|
| 第1段階: 素材集め | 議事録・チャットログ・過去資料を1つのフォルダに放り込む(この時点では整理しない) | 出典・取得日・対象範囲 | 生素材フォルダ |
| 第2段階: 構造化 | Claude Codeに「この素材から構造化Wikiを作って」と依頼する | 原典を維持し、整理結果と照合 | トピック別のMarkdown Wiki |
| 第3段階: 運用 | 質問→回答→確認→追記のループを日次で回し、答えられなかった質問を素材追加のTODOにする | 更新履歴と未回答事項 | 出典と更新を管理する外部脳 |
整理はAIに依頼し、人間は素材を集めるだけでなく、整理された内容と出典の対応も確かめます。
また、外部脳の置き場所はローカルのMarkdown(Obsidian Vault)が第一候補です。クラウド型のナレッジツールと違い、Claude Codeが直接ファイルを読み書きできるため、「読ませる→書かせる→育てる」のループが途中で崩れません。
外部脳は作って終わりではなく、デイリーノートの運用やCLAUDE.mdの設計と組み合わせることで、日々の仕事の中で自然に育っていきます。社内展開まで視野に入れる場合は、会社ナレッジのAI活用もあわせてご覧ください。
精度を落とさないための運用ルール5ヶ条
ここでは、出典と更新を管理するための5つの運用案を示します。資料量と重要度に合わせて適用してください。
①出典を必ず残させる。 Wikiの各項目に元ファイル名を残す指示を最初から入れます。経営判断に使う情報は「どこから来たか」を10秒で遡れることが最低条件です。
②「資料に無い」と言わせる。 根拠が無い部分を推測で埋めさせない指示を定型化します。これを怠ると、外部脳の信頼性そのものが崩れます。
③変更を原典と照合する。週ごとに追加された素材と、結論が変わった項目を確認します。AIに整理を依頼した後も、重要な変更は出典と照合します。具体的な頻度は、情報の更新量と業務に合わせて決めます。
④機密は区分してから入れる。 顧客の個人情報や契約書の原本は外部脳に入れず、参照ルールだけ書きます。安全設計はAI社員のセキュリティ対策にまとめています。
⑤小さな構成から広げる。 原典を置くrawと、整理した説明を置くwikiを分け、まず一つのテーマで試します。分類が足りなくなったら、実際に探したい情報に合わせてフォルダや索引を追加します。
実務で試すときに確認したいこと
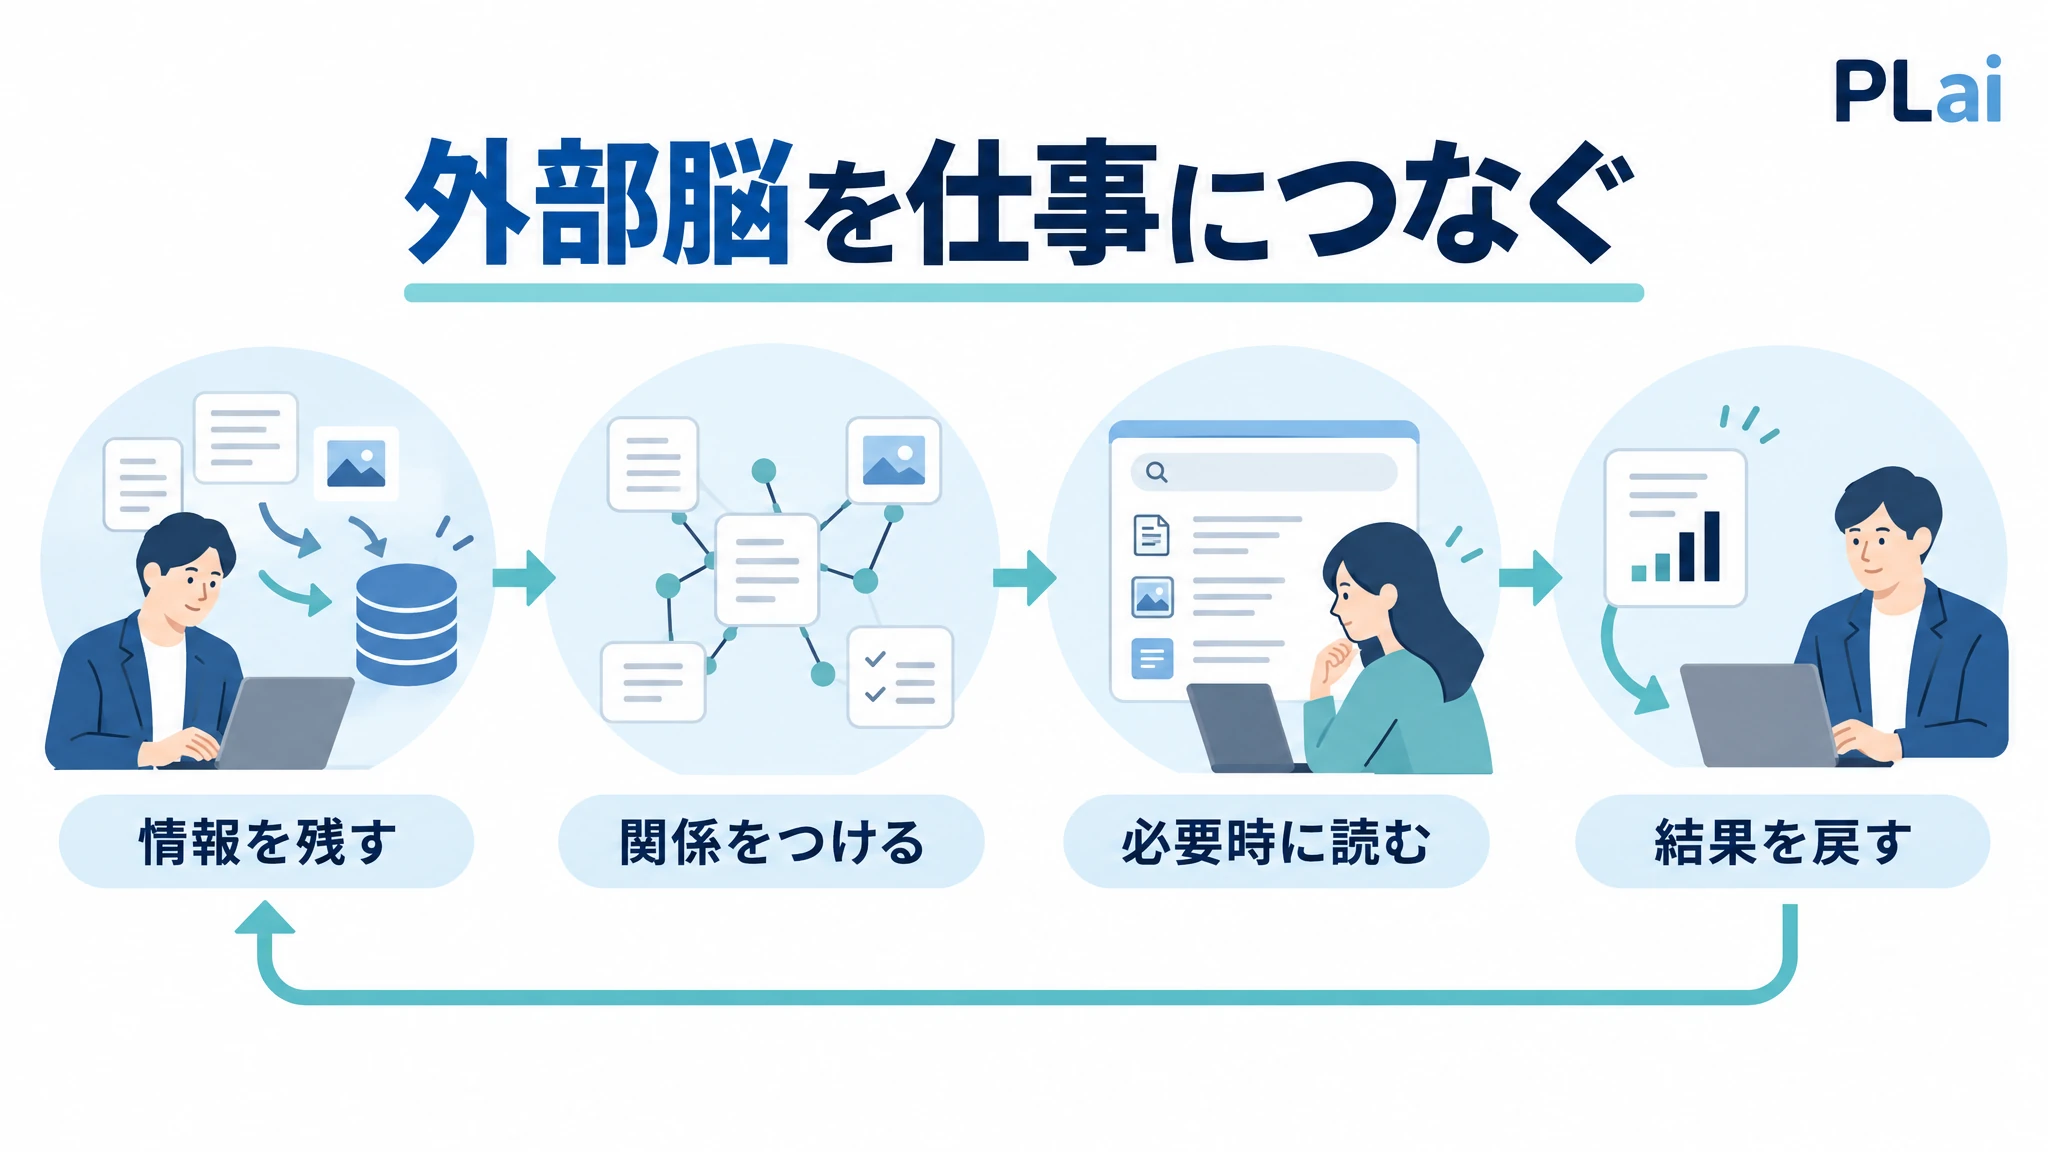
情報を保存した後は、実際の仕事でどのノートが役立ったかを振り返ってみましょう。回答に使った根拠と、足りなかった情報を記録すると、次に整える知識が見えてきます。提案された概念とPLaiでの運用例を区別し、保存量が増えただけで知識の精度が自動的に上がるとは考えないようにします。
この記事の「外部脳を仕事につなぐ」を、自社の業務[業務名]に置き換えて検討します。
前提:[現在の手順・使ってよい資料・確認担当]
確認したいこと:情報を貯めるだけでなく、使った結果を知識へ戻していますか?
上の資料で分かること、不明なこと、最初に確認することを分けて整理してください。事実や実績を作らず、提案には理由を添えてください。外部送信や設定変更は行わず、検討用の案を出してください。
よくある質問
Q. ObsidianやNotionで作るのと何が違いますか?
ノートアプリは「素材の置き場所」で、Claude Codeは「その素材を読んで構造化Wikiを作り、質問に答える働き手」です。役割が違うので競合しません。実際、Obsidianに素材を貯めてClaude Codeに読ませる組み合わせが最も手軽で強力です。両者の違いはObsidian vs Notion徹底比較も参考にしてください。
Q. プログラミングができなくても作れますか?
作れます。バージョン1はフォルダを1つ作ってテキストを10個入れ、Claude Codeに「読んでWikiを作って」と日本語で頼むだけです。コードは一切書きません。
Q. 最初はどれくらいの素材から始めればいいですか?
10個で十分です。最初から完璧な網羅を目指すと挫折します。気になった記事・メモ・動画の書き起こしを追加し、回答と出典を確かめながら内容を整えていきます。
Q. 個人の外部脳を、会社のナレッジ基盤に発展させられますか?
応用できます。会社で使う場合は、事業ナレッジや業務手順を集めることに加えて、閲覧権限、更新担当、正本、古い情報の扱いを決める必要があります。ナレッジ構築や会社のナレッジをAI化する方法も参考にしてください。
Q. どのくらいの期間で効果を実感できますか?
少量の素材でも、出典を確認しながら回答を得る流れは試せます。ただし、経営判断や営業準備に役立つまでの期間は、素材の内容と用途によって変わります。まず過去に答えを確認できた質問で試し、必要な情報を見つけられたか、出典は正しいか、確認の手間が減ったかを記録してください。
Q. チームや会社全体で1つの外部脳を共有できますか?
できます。共有フォルダやGit管理のリポジトリに外部脳を置けば、複数人が同じ知識ベースに質問できます。ただし「読む人」と「書く人」のルールを先に決めないと荒れるため、展開手順はObsidian×Claude Code連携ガイドの社内展開の章を参考にしてください。
Q. 顧客情報や契約書のような機密データも入れて大丈夫ですか?
原本をそのまま入れるのは避けてください。外部脳には「どこに原本があるか」「扱いのルール」だけを書き、原本はアクセス制御された場所に置くのが原則です。AIに読ませる範囲の設計はセキュリティ対策ガイドで詳しく解説しています。
まとめ:今日、フォルダ1個から始められる
AI外部脳は、素材と整理した知識を蓄積し、必要なときに根拠へ戻れるようにする仕組みです。素材の品質、更新の担当、回答の確認方法を整えたうえで、業務に役立つ範囲を広げます。
最初は、小さな資料群から試せます。関心のあるテーマの素材を集め、原典を残したままWikiを作るようClaude Codeへ依頼してください。できた内容と出典を確認するところまでが最初の一歩です。業務の実行まで広げたい場合は、AI社員構築代行のページで、知識の整理に加えて必要になる設計と導入の流れを紹介しています。